Savoir ce qu’un agent ajoute à un RAG, et dans quels cas il ne fait qu’alourdir le système.
Un RAG classique suit un trajet fixe. La question est vectorisée, les passages proches sont retrouvés, puis ajoutés au prompt. Le LLM n’est appelé qu’une fois, pour générer la réponse.
Le RAG agentique utilise aussi le modèle pour décider : quelle source interroger, comment reformuler, si le résultat suffit.
La chaîne, du document à la réponse
Toute la chaîne
Un RAG a deux moitiés. La préparation tourne une fois, puis à chaque changement de documents. La réponse tourne à chaque question. Tout ce que l’agent pourra trouver s’est décidé à gauche.
La plupart des échecs d’un RAG naissent à gauche, bien avant que le modèle écrive un mot.
1. Le découpage
Un modèle ne peut pas relire toute une bibliothèque à chaque question : on coupe donc les documents en passages. Trop long, un passage mélange plusieurs sujets. Trop court, il perd son sens.
Coupez là où le document coupe. Une taille fixe aurait pu séparer « sous 30 jours » de la règle qui lui donne son sens.
2. L’embedding
Un modèle d’embedding transforme chaque passage en vecteur, une liste de nombres qui résume son sens. Deux textes qui disent la même chose obtiennent des vecteurs proches, même avec des mots différents.
Le modèle place les phrases selon leur sens, pas leur orthographe. Ces valeurs sont illustratives, et un vrai vecteur compte des centaines ou des milliers de nombres.
3. La base vectorielle
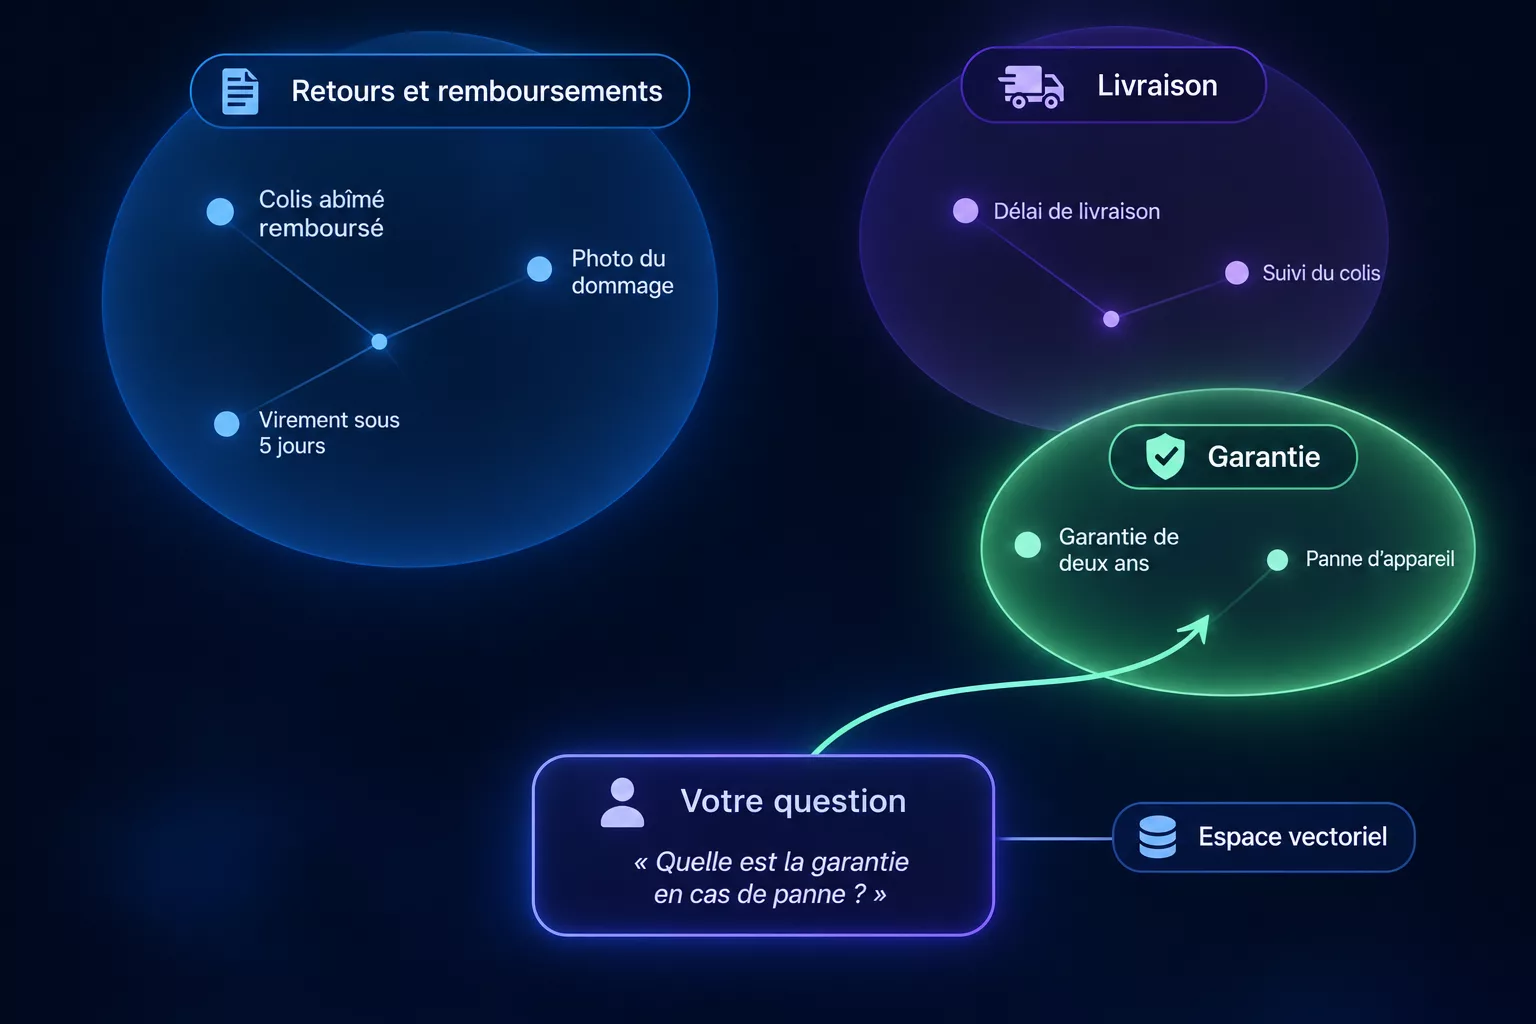
La base garde chaque vecteur avec son texte, sa source et ses droits. Elle répond vite à une seule question : quels passages sont les plus proches de ce vecteur ? Gardez les droits ici, pour filtrer avant de classer.
La question devient elle aussi un vecteur et tombe dans la zone Garantie : les passages proches reviennent, les autres restent loin. Cette carte en 2D est un croquis d’un espace qui a bien plus de dimensions. Les scores sont illustratifs, et la proximité se mesure en général par similarité cosinus.
4. Les types de recherche
Une base vectorielle répond à un seul genre de question. D’autres demandent les mots exacts, une requête en base, un graphe de relations ou une lecture directe des fichiers. Pour un agent, chacune est un outil à part : c’est pour cela que le choix de la source compte.
En cyan, on cherche dans des documents, en violet dans des données structurées, en vert on va directement à la source. Choisissez d’après la question, pas d’après l’outil que vous avez déjà.
5. Combiner les recherches et reclasser
La recherche hybride est le choix habituel sur des documents. Lancez les deux recherches, fusionnez leurs classements, puis laissez un modèle plus lent relire seulement les meilleurs candidats.
Chaque recherche met un autre document en tête. L’article 12 gagne parce que les deux l’ont trouvé, et BM25 attrape les codes exacts que les vecteurs ratent.
6. L’agent
Jusqu’ici, le trajet ne change jamais. L’agent fait de la recherche un outil qu’il peut utiliser, ignorer ou relancer. C’est la seule différence entre un RAG classique et un RAG agentique.
Sans agent, le trajet est fixe. Avec un agent, chaque décision ajoute un appel au modèle : plafonnez les essais.
Quatre rôles fréquents
Routage : choisir la bonne base, ou aucune si la question sort du périmètre.
Découpage de requête : scinder une question complexe, confier les parties, fusionner les réponses.
ReAct : adapter la recherche suivante au résultat précédent.
Planification puis exécution : établir un plan complet avant de chercher.
Ce qui compte le plus
Le découpage en tailles fixes est un point de départ, pas une solution. La recherche hybride (mots et sens) et le reclassement améliorent souvent plus la qualité qu’un agent.
Mesurez d’abord la récupération seule : si le bon passage n’arrive pas, le meilleur agent du monde répondra mal.
Tout ce qu’on récupère est une entrée non fiable. Un document peut contenir des instructions adressées à l’agent.
Sur des données à droits, filtrez avant de classer. Un filtre après coup peut laisser des documents interdits influencer les résultats.
Le compromis
Chaque décision du modèle ajoute un appel, donc du coût et de la latence. Pour une question simple sur une seule base, le RAG classique reste plus rapide et moins cher. Et aucun des deux ne supprime totalement les hallucinations.
Réparez la récupération avant d’ajouter un agent.
Exemple : Fusionner deux classements
La recherche par mots trouve le numéro d’article exact, la recherche vectorielle trouve le sens. La fusion par rang les réunit avec les seuls rangs : les deux types de score n’ont jamais à être comparés.